Jenkins 배치 220개를 Temporal로 옮기며 고민한 것들
어느 날 한 개발자분께 메시지가 왔습니다.
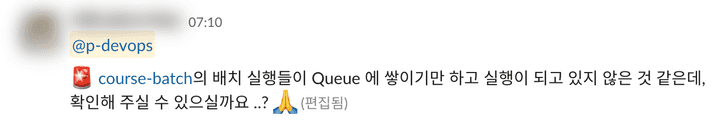
배치가 실행되지 않아 확인해 보니 Jenkins의 디스크가 가득 차 멈춰 있었습니다. 빌드 이력 보존 설정(logRotator)이 빠진 잡들의 이력이 정리되지 않고 계속 쌓인 것이 원인이었습니다. 그 사이 큐에는 실행을 기다리는 배치가 3,000건 가까이 쌓였습니다.
쌓여 있던 빌드 이력을 정리해 Jenkins를 다시 띄웠지만, 큐에 밀린 배치를 그대로 실행하면 사용자 알림이 엉뚱한 시점에 나갈 수 있었습니다. 결국 큐를 전부 비우고 백엔드 개발자분들이 다시 돌려야 할 배치를 직접 골라 수동으로 실행했습니다.
이 글에서는 이런 일이 반복되던 배치 시스템을 Jenkins에서 Temporal로 옮기며 고민한 것들을 정리했습니다.
기존 배치 구조
Jenkins는 인프런과 랠릿, 내부 서비스 등에 배치 시스템으로 사용되어 왔습니다.
- 서비스마다 개발/운영 Jenkins를 하나씩 띄워 EC2 12대에서 Jenkins가 각각 단독으로 동작했습니다.
- 잡 220개가 하루에 약 15,900번 실행됐습니다. 각 서비스는 배치 코드를 Docker 이미지로 빌드하고, Groovy로 작성한 Jenkins 잡은 파이프라인에서 그 이미지를
docker run하거나 서비스의 배치용 API를curl로 호출했습니다.
Jenkins에서 겪은 문제
한 번 멈추면 모든 배치가 멈추는 Jenkins
Jenkins는 잡 정의, 빌드 이력, 로그, 배치 이미지를 모두 디스크에 저장하고, 디스크가 가득 차면 모든 배치가 멈춥니다. 이 문제는 Jenkins를 도입한 시기부터 거의 분기마다 반복됐습니다. 빌드 이력 보존 개수를 제한하고 디스크도 여러 번 늘렸지만 원인이 매번 조금씩 달라 근본적으로 막기는 어려웠습니다.
플러그인도 Jenkins를 멈추게 했습니다. Jenkins는 대부분의 기능을 플러그인으로 추가하고 플러그인끼리 서로 의존합니다. 2024년 10월에는 Datadog 플러그인을 새로 설치하고 재시작했는데 이미 쓰고 있던 GitHub 플러그인과 의존성이 맞지 않아 Jenkins가 아예 뜨지 않았습니다. Jenkins와 GitHub 플러그인을 업그레이드해 다시 띄울 때까지 그 Jenkins의 배치는 하나도 실행되지 않았고, 복구한 뒤에는 놓친 배치를 찾아 하나씩 다시 실행해야 했습니다. 이런 문제는 재시작하기 전에는 발견하는 것이 어렵고, 버전과 플러그인 구성이 조금씩 다른 Jenkins 12대를 업데이트할 때마다 같은 위험을 감수해야 했습니다.
실패해도 모르는 배치
Jenkins에서는 Slack 알림을 보내는 함수를 공용 Groovy 라이브러리(Jenkins Shared Library)로 만들어 두었지만, 언제 알림을 보낼지는 잡마다 Groovy 파일에 직접 설정해야 했습니다. 그러다 보니 어떤 상황을 실패로 보고 알림을 보낼지도 잡마다 달랐습니다. 한 데이터 동기화 잡은 중간 단계가 DB 인증 오류로 계속 실패했는데도 마지막 단계가 성공하면서 잡 전체가 SUCCESS로 기록돼 알림이 한 번도 오지 않았습니다. 설정 실수이긴 하지만 잡 220개가 각자 알림을 설정하는 구조라면 이런 실수는 어디선가 계속 생길 수밖에 없습니다. 게다가 Jenkins 자체가 멈추면 잡이 실패하지도 끝나지도 않아서 알림이 아예 나가지 않았습니다.
평소에는 놀고, 몰리면 부족한 서버
배치는 정해진 시각에 잠깐 돌고 끝나는데 Jenkins 서버는 24시간 켜져 있어야 합니다. 호스트별 평균 CPU 사용률은 계정 관련 배치가 몰린 2대를 빼면 6%도 되지 않았습니다. 반대로 배치가 몰리는 시간에는 같은 EC2에서 잡들이 자원을 나눠 써야 해서 무거운 잡이 자원을 점유하면 다른 잡의 실행이 뒤로 밀릴 수 있었습니다. 그래서 사용자가 적은 새벽 시간대에 배치를 몰아서 돌리기 어려웠고 여러 시간대로 나눠 실행해야 했습니다.
배치가 몰리는 시간에만 서버를 늘리는 방법으로 Jenkins의 EC2 Fleet 플러그인도 검토했습니다. 해당 플러그인은 잡을 실행할 때 필요한 만큼 에이전트 인스턴스를 띄워 줍니다. 하지만 배치는 도중에 끊기면 안 되기 때문에 Spot이 아닌 On-Demand 인스턴스를 써야 했고, 인스턴스가 뜨기까지 보통 2분 정도 걸려서 정해진 시각에 바로 실행돼야 하는 배치에는 맞지 않다고 판단했습니다.
검토한 대안
이 문제들은 오래전부터 알고 있었지만 실제로 옮기게 된 계기는 인프라를 AWS EKS로 옮기는 작업이었습니다. 서비스가 EKS로 넘어가게 되면서 Jenkins가 EC2 비용에서 큰 비중을 차지하게 됐습니다. 또한 개발팀에서도 Groovy로 작성한 잡은 수정하기 불편하고 배치를 Jenkins UI가 아니라 서비스 코드베이스 안에서 정적 타입 언어로 관리하고 싶다는 의견이 많았습니다.
필요할 때만 자원을 쓰고 배치를 코드로 관리할 수 있는 후보는 두 가지였습니다.
| Argo Workflows | Temporal | |
|---|---|---|
| 정의 방식 | YAML | 코드(SDK) |
| 설정 관리 | GitOps 저장소 | 워커 코드 |
| 걸린 점 | YAML, GitOps 학습 | 서버, 워커 운영 |
처음에는 CI/CD 파이프라인에서 이미 사용하고 있던 Argo Workflows로 옮기려고 했습니다. 하지만 CI/CD 파이프라인은 데브옵스팀에서 관리해 왔기 때문에 개발팀은 Argo Workflows를 직접 다뤄 본 적이 없었고, YAML 문법과 GitOps 저장소 방식에도 새로 익숙해져야 했습니다. Groovy를 벗어나려다 또 다른 DSL을 배우게 되는 셈이었습니다.
그래서 배치 시스템을 구성할 때 자주 언급되는 Temporal을 골랐습니다.
- 워크플로를 일반 프로그래밍 언어로 작성합니다. 개발팀이 익숙한 언어와 도구(타입 검사, 테스트, 코드 리뷰)를 재사용할 수 있습니다.
- 실행 상태와 이력이 DB에 기록됩니다. 서버나 워커가 재시작돼도 이어서 실행하고 쌓인 이력은 분석에도 활용할 수 있습니다.
- 기존 배치 이미지를 그대로 쓸 수 있습니다.
Temporal에서 Workflow는 실행 순서를 적은 코드이고, Activity는 그 안에서 실제 일을 하는 단위입니다. 서버는 언제 무엇을 실행할지만 관리하고, 실제 실행은 별도의 워커가 맡습니다. Temporal 서버는 EKS에 직접 띄우고 상태 저장소는 기존 Aurora PostgreSQL에 DB를 추가해 별도 비용이 들지 않게 했습니다. 대신 서버는 데브옵스팀이 직접 운영해야 하고 각 팀은 워커를 운영하면서 Temporal의 규칙을 지켜야 합니다. 그래서 반복되는 코드는 공용 라이브러리로 구성하고 많이 사용하는 구조는 예제로 제공해 쉽게 옮길 수 있게 했습니다.
이관하면서 중요하게 생각한 것
- 개발팀 작업 최소화: 잡을 옮기는 일은 대부분 개발팀이 합니다. 새로 알아야 할 것이 많으면 이관을 끝내기 어렵기 때문에 최대한 간단하게 구성할 수 있게 합니다.
- 실패 알림 보장: 알림을 잡마다 직접 구성하지 않고 공용 라이브러리로 보장합니다.
- 중복 실행 방지: 워커가 죽고 다른 워커가 이어받아도 배치가 두 번 돌지 않게 합니다.
- 멈춤 감지: “실행 중”으로 남은 채 아무도 모르는 상황을 없앱니다.
- 실행 추적: 한 실행의 로그를 한 번에 찾을 수 있게 합니다.
서비스별 워커와 공용 라이브러리
개발팀이 Temporal을 몰라도 되도록 처음에는 서비스 저장소에 잡 정의 YAML만 두면 데브옵스팀이 운영하는 범용 워커 하나가 읽어 실행하는 방식을 시도했습니다. 하지만 개발팀은 데브옵스팀이 정의해 둔 YAML 구조만 쓸 수 있어서 새로운 흐름이 필요할 때마다 스키마를 늘려야 했습니다. 결국 또 하나의 DSL을 만드는 일이었습니다.
그래서 각 서비스 저장소의 batch/ 디렉터리에 서비스별 워커를 두고 데브옵스팀은 공통 부품을 라이브러리로 제공하는 구조로 바꿨습니다. 워커는 서비스 언어와 관계없이 개발팀 모두가 다룰 수 있는 TypeScript로 통일해 라이브러리를 한 벌만 관리하도록 했습니다.
Temporal SDK는 Workflow, Activity, Schedule을 만드는 기본 기능만 제공하고 있어서 배치 실행과 실패 알림은 팀마다 직접 만들어야 했습니다. 그래서 서비스마다 동일하게 구현해야 하는 코드는 라이브러리로 배포해 개발팀이 직접 구현하지 않아도 사용할 수 있도록 했습니다.
defineSchedule: 스케줄을 코드로 정의하고 워커가 기동할 때 서버와 동기화합니다.runContainer,runHttp: 배치 이미지를 Kubernetes Job으로 실행하거나 서비스의 배치용 API를 호출합니다.alertOnFailure: 최종 실패하면 Slack으로 알림을 보냅니다.
Jenkins 잡에 설정해 두던 내용을 defineSchedule의 각 항목에 맞춰 코드로 옮기면 됩니다.
// schedules.ts
export const schedules = [
  defineSchedule({
    id: 'daily-report',
    description: '매일 03:00 KST 일간 리포트 생성',
    cron: '0 3 * * *',
    timezone: 'Asia/Seoul',
    overlap: 'skip',
    workflow: containerOnly,
    args: [
      {
        command: ['node', 'dist/batch/daily-report.js'],
        slackChannel: '#batch-alert',
        retries: 2,
      },
    ],
  }),
];
스케줄이 실행하는 containerOnly는 라이브러리가 예제로 제공하는 워크플로입니다. Jenkins의 docker run 잡은 대부분 이 워크플로 하나로 옮겨집니다.
// workflows/container-only.ts
export async function containerOnly(input: ContainerOnlyInput) {
  const { runContainer } = batchActivities({
    startToCloseTimeout: input.timeout ?? '2h',
    retry: { maximumAttempts: (input.retries ?? 0) + 1 },
  });

  // 최종 실패하면 Slack으로 한 번 알립니다.
  return alertOnFailure({ slack: input.slackChannel }, () =>
    // 워크플로가 취소되면 띄워 둔 Job을 지웁니다.
    withContainerCleanup(async () => runContainer({ command: input.command, env: input.env })),
  );
}
실패 알림 보장
alertOnFailure로 감싼 범위에서 최종 실패가 나면 Slack으로 알림을 보냅니다. 알림 발송은 배치 실행과 분리된 별도의 Activity입니다. 그래서 배치가 이미 실패로 끝난 뒤 Slack이 잠시 응답하지 않거나 알림을 보내던 워커가 죽더라도 Temporal은 배치를 처음부터 다시 돌리지 않고 알림 단계만 다시 시도합니다. Jenkins에서는 잡마다 알림을 따로 설정해야 했지만 이제는 라이브러리가 실행과 알림을 하나로 묶어 제공하므로 잡마다 알림이 누락되지 않습니다.
중복 실행 방지
워커가 Kubernetes Job을 만든 직후 문제가 발생해서 정상 동작을 하지 못하면 다른 워커가 이어받을 때 Job을 또 만들어 같은 배치가 두 번 실행될 수 있습니다. 이를 막기 위해 Job 이름을 실행 ID(Temporal의 Run ID)와 시도 번호로 생성하도록 했습니다. 이전 시도 이름의 Job이 아직 돌고 있거나 성공했는지 먼저 확인하고, 있으면 그 Job을 이어서 감시하고 없으면 새로 생성합니다. 또한, Kubernetes 쪽 재시도(backoffLimit)는 0으로 두어 시도 횟수는 Temporal에서만 관리합니다.
멈춤 감지
Temporal은 오래 도는 작업이 주기적으로 살아 있다는 신호(heartbeat)를 보내고 이 신호가 끊기면 서버가 실패로 처리하는 기능을 제공합니다. 라이브러리에서 모든 단계에 타임아웃을 걸고, 컨테이너와 API 호출이 끝나기를 기다리는 동안 heartbeat를 보내도록 해 두었습니다. 그래서 워커가 멈췄더라도 서버가 그 단계를 실패로 처리하고, 최종 실패하면 알림이 나갑니다.
워커가 모두 내려가거나 스케줄이 실행을 시작하지 않으면 실패할 실행 자체가 없습니다. 이런 상황은 Temporal이 제공하는 메트릭(작업을 가져갈 워커가 없을 때 쌓이는 값, 스케줄 실행 성공 횟수)에 알림을 걸어 모니터링하고 있습니다.
Temporal 서버가 멈췄다가 다시 뜨면 그동안 놓친 실행을 따라잡습니다. Temporal 기본값으로는 1년 전 실행까지 따라잡기 때문에 밀린 배치가 한꺼번에 실행되지 않도록 예정 시각이 1시간 이내인 실행만 따라잡게 했습니다.
실행 추적
Temporal UI는 어떤 단계가 실행되고 실패했는지는 보여 주지만 Jenkins처럼 배치가 출력한 로그는 보여 주지 않습니다. 인프랩은 서비스 모니터링에 이미 Datadog을 사용하고 있어서 배치 로그도 Datadog으로 보내기로 했습니다. 다만 Datadog이 자동으로 붙이는 태그만으로는 한 실행의 여러 단계와 재시도 로그를 묶을 수 없었습니다. 그래서 라이브러리에서 Job 파드에는 ad.datadoghq.com/tags 애노테이션으로, 워커 로그에는 속성으로 같은 실행 ID를 넣었습니다. 이제 알림이나 Temporal UI의 링크 하나로 그 실행의 로그를 모아 볼 수 있습니다.
이관 진행 방식
220개의 잡을 한 번에 옮길 수는 없어서 Jenkins와 Temporal을 함께 운영하면서 서비스별 잡 단위로 옮기고 있습니다. 서비스마다 Temporal namespace를 만들어 각 팀이 자기 배치만 모아 볼 수 있게 했습니다.
데브옵스팀은 라이브러리를 만들고 서비스별 워커를 만드는 방법을 정리한 문서와 Jenkins 개념이 Temporal에서 무엇에 해당하는지 정리한 이관 가이드를 개발팀에 공유했습니다. 라이브러리 저장소에는 그대로 복사해 쓸 수 있는 예제를 두었습니다. 또 라이브러리 새 버전을 배포하면 이를 쓰는 저장소마다 업데이트 PR이 자동으로 올라가게 해서 이관 도중 고친 내용을 각 팀이 바로 반영할 수 있게 했습니다.
전환할 때 가장 조심한 것은 같은 배치가 Jenkins와 Temporal에서 함께 실행되는 일이었습니다. 처음에는 스케줄을 켜고 끄는 상태(enabled)도 코드에서 관리하도록 했습니다. 그런데 문제가 생기면 UI에서 바로 스케줄을 멈출 수 있어야 하는데, 워커가 다시 뜨면서 스케줄을 동기화하면 멈춰 둔 상태가 코드 값으로 되돌아갔습니다. 반대로 UI에서 바꾼 값을 우선하면 코드와 실제 상태가 어긋납니다. 그래서 새 스케줄은 항상 일시정지 상태로 등록하고 실행 여부는 Temporal UI에서만 정하도록 바꿨습니다.
실제 전환은 잡마다 정한 담당 개발자가 맡았고 백엔드 개발자 한 분이 잡별 담당자와 진행 상황을 시트로 관리해 주셨습니다. 담당자는 환경 변수, IAM 권한, 잡 파라미터가 Jenkins와 같은지 확인한 뒤 개발 환경부터 Jenkins 잡을 끄고 Temporal 스케줄을 켰습니다. 전환한 뒤에는 실패 알림이 오면 바로 대응했습니다.
배포한 뒤 문제가 생기면 Argo CD에서 이전 버전으로 되돌릴 수 있도록 했습니다. 배치 이미지와 워커 이미지를 같은 태그로 빌드하고 워커가 기동할 때 스케줄을 동기화하기 때문에 배치 코드와 워커, 스케줄 설정이 함께 이전 버전으로 돌아갑니다.
이관 도중에는 배치 코드에 오류가 없는데도 실패로 처리된 일이 있었습니다. 노드를 자동으로 늘리고 줄이는 Karpenter가 노드를 줄이면서 실행 중인 배치 파드를 내보낸 것이 원인이었습니다. Kubernetes 쪽 재시도를 0으로 두었기 때문에 파드가 죽으면서 그 시도는 실패로 처리되고 재시도를 설정하지 않은 잡은 그대로 실패했습니다. 그래서 라이브러리가 만드는 배치 파드에는 Karpenter가 정리하지 않도록 표시(karpenter.sh/do-not-disrupt)를 붙이고 실패 알림에 파드가 내보내진 이유를 함께 싣도록 했습니다.
Temporal로 이관하면 달라지는 것
- 비용: Jenkins EC2를 모두 내리면 Temporal 서버, 워커, 배치 실행 노드까지 모두 더해도 배치 시스템 비용이 절반 넘게 줄어듭니다.
- 배치 정의: 잡 추가와 스케줄 변경이 코드로 바뀌어 PR 리뷰를 거칩니다. 배포하면 스케줄 설정도 함께 반영되고 롤백하면 함께 되돌아갑니다.
- 실패 알림: 라이브러리가 제공하는 예제 워크플로를 쓰면 알림을 따로 설정하지 않아도 됩니다. 워크플로를 직접 만들더라도
alertOnFailure로 감싸면 같은 형식의 알림이 나갑니다. - 실행 시각: 배치마다 별도의 Kubernetes Job으로 자원을 보장받아 여러 배치를 같은 시간대에 몰아서 실행해도 다른 잡 때문에 밀리지 않습니다. 노드가 부족하면 Karpenter가 On-Demand 노드를 띄우는데 평균 30초 정도면 준비됩니다. 검토할 때 인스턴스가 뜨기까지 2분 정도 걸렸던 EC2 Fleet 플러그인과 달리 이 정도 대기는 감안할 수 있다고 판단했습니다.
- 디스크: 서버 디스크를 신경 쓰지 않아도 됩니다. 실행 이력은 DB에 30일 보존되고, 로그는 Datadog에 있습니다.
실패 알림에서 “로그 보기”를 누르면 그 실행의 Datadog 로그가, “워크플로 보기”를 누르면 Temporal UI의 실행 이력이 열립니다.
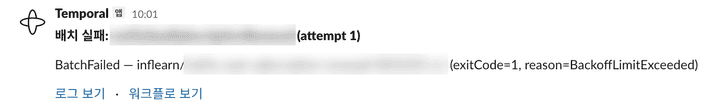
대신 구조는 Jenkins보다 복잡해졌습니다. 개발팀이 Temporal의 개념과 Datadog 검색 방법을 새로 익혀야 하는데 이 부분은 이관 가이드와 예제로 채워 가고 있습니다.
마치며
이번 이관에서 가장 오래 고민한 것은 Temporal을 고르는 일보다 개발팀이 무엇을 신경 쓰지 않아도 되게 할지 정하는 일이었습니다. Jenkins에서도 공용 라이브러리는 있었지만 알림은 잡마다 직접 설정해야 해서 빠뜨리는 잡이 생겼습니다. 이번에는 알림, 멈춤 감지, 중복 실행 방지, 로그 연결을 배치 실행 과정에 기본으로 넣어 잡을 옮기면 함께 따라오도록 했습니다.
아직 Jenkins에 남아 있는 잡이 있습니다. 남은 잡을 모두 옮기면 Jenkins EC2를 내릴 예정입니다. 이와 함께 실행 이력을 데이터 분석용 저장소로 옮겨 누구나 AI 도구로 배치 현황을 볼 수 있게 할 계획입니다. 또 모니터링을 보강하고 라이브러리를 고도화해 배치가 더 쉽고 안정적으로 동작하도록 운영해 나가려 합니다. 비슷한 고민을 하고 계신 분들께 이 글이 도움이 되기를 바랍니다.